Inhalt
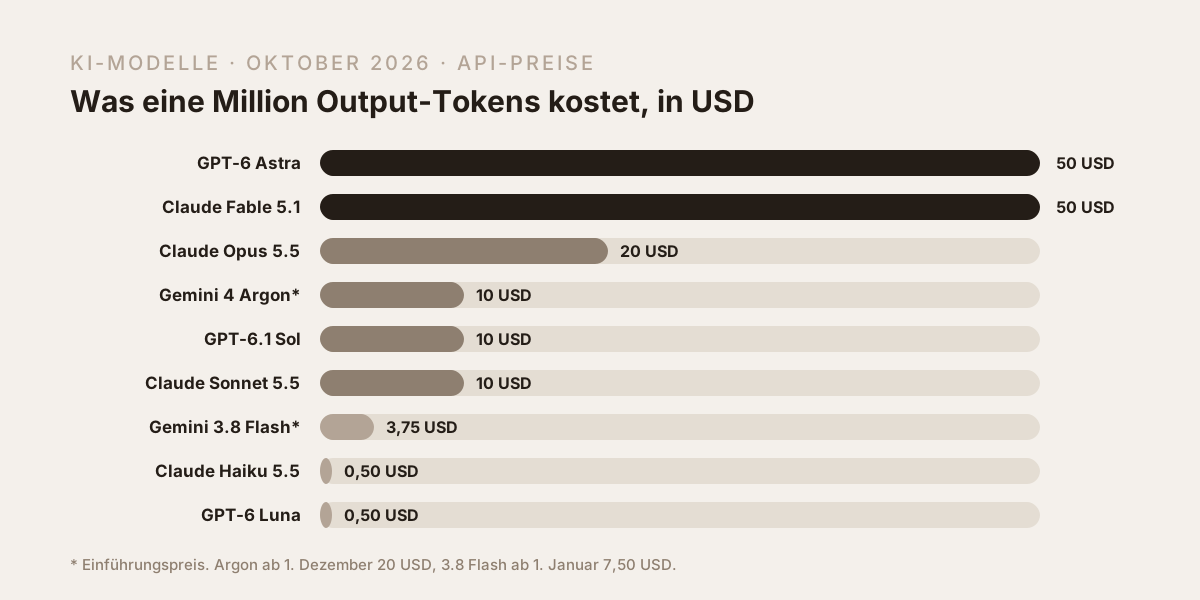
Im Herbst 2026 hat sich weniger an der Spitze verändert als in der Mitte. GPT-6 Astra und Claude Fable 5.1 sind weiterhin die stärksten Modelle. Neu ist, dass GPT-6.1 Sol, Claude Opus 5.5 und Claude Sonnet 5.5 sowie Googles neues Spitzenmodell Gemini 4 Argon zum Einführungspreis fast dieselbe Leistung für einen Fünftel bis zwei Fünftel des Preises liefern. Für die meisten Aufgaben in einem KMU ist das teuerste Modell damit nicht mehr die richtige Wahl.
Seit meinem Vergleich von GPT-6 Astra und Claude Fable 5.1 Anfang September sind innert fünf Wochen acht neue Modelle erschienen. Dieser Beitrag ordnet sie ein: was sie kosten, was die Benchmarks zeigen, was wir selbst mit drei aktuellen Modellen gemessen haben und welches Modell ich heute für welche Aufgabe nehme. Geht es Ihnen um die Wahl des Assistenten für den Büroalltag statt um das Modell dahinter, hilft ChatGPT vs. Claude für KMU.
Was sich seit September geändert hat
| Datum | Was | Bedeutung |
|---|---|---|
| 22. September | OpenAI GPT-6 Sol und GPT-6 Luna | Mittelklasse und Billigmodell, beide dauerhaft günstiger als die Vorgänger |
| 22. September | Claude Opus 5.5 | Fast Fable-Niveau für 4 und 20 USD statt 10 und 50 USD |
| 28. September | Claude Sonnet 5.5 | Neue Mittelklasse von Anthropic, Sonnet 5 ist jetzt Legacy |
| 29. September | GPT-6.1 Sol | Fast Astra-Leistung zu rund einem Fünftel des Preises |
| 6. Oktober | Mistral Large 4 als Vorschau | Europäisches Modell, offene Gewichte angekündigt |
| 7. Oktober | Claude Haiku 5.5 | Billigmodell mit 1 Million Tokens Kontext |
| 13. Oktober | Gemini 4 Argon öffentlich | Googles neues Spitzenmodell, in der App nur in den Abos AI Pro und Ultra |
Zwei Dinge fallen auf. Erstens hat OpenAI keinen Astra-Nachfolger gebracht, sondern das Mittelklasse-Modell so stark gemacht, dass es für viele Aufgaben an Astra heranreicht. Zweitens senken alle drei grossen Anbieter die Preise in der Mitte, während die Spitzenmodelle teuer bleiben.
Die Preisliste
Preise der Programmierschnittstelle (API) in USD pro Million Tokens, Input und Output. Für die Abos in ChatGPT, Claude und Gemini zahlen Sie einen Monatspreis, dort zählen die Nutzungslimits.
| Modell | Anbieter | Input | Output | Einordnung |
|---|---|---|---|---|
| GPT-6 Astra | OpenAI | 10 | 50 | Spitzenmodell |
| Claude Fable 5.1 | Anthropic | 10 | 50 | Spitzenmodell |
| Claude Opus 5.5 | Anthropic | 4 | 20 | obere Mittelklasse |
| Gemini 4 Argon | 2 (ab 1. Dezember 4) | 10 (ab 1. Dezember 20) | Spitzenmodell, Einführungspreis | |
| GPT-6.1 Sol | OpenAI | 2 | 10 | Mittelklasse |
| Claude Sonnet 5.5 | Anthropic | 2 | 10 | Mittelklasse |
| Gemini 3.8 Flash | 0,75 (bis Ende Jahr) | 3,75 (bis Ende Jahr) | günstig, schnell | |
| Claude Haiku 5.5 | Anthropic | 0,10 | 0,50 | Billigmodell, bis 100'000 Tokens pro Anfrage |
| GPT-6 Luna | OpenAI | 0,10 | 0,50 | Billigmodell |
Was das in der Praxis heisst: Eine Aufgabe, die mit Fable 5.1 einen Franken kostet, kostet mit Sonnet 5.5 oder GPT-6.1 Sol rund zwanzig Rappen und mit Haiku 5.5 oder Luna rund einen Rappen. Bei hundert solchen Aufgaben am Tag ist das der Unterschied zwischen einem Budgetposten und einer Fussnote.
Was die Benchmarks zeigen
Die Benchmarks sind im Herbst 2026 schwerer zu vergleichen als früher. Der lange übliche SWE-bench Verified ist praktisch ausgereizt, die Hersteller veröffentlichen unterschiedliche Tests, und viele Werte sind Herstellerangaben. Die folgende Tabelle zeigt nur Werte, die für mindestens zwei Modelle auf demselben Test vorliegen.
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Gemini 4 Argon | Was er misst |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57,7 % | 55,8 % | 57,6 % | Agentische Arbeit im Terminal |
| Humanity's Last Exam (mit Werkzeugen) | 57,2 % | 65,0 % | – | Sehr schwere Fachfragen |
| GPQA Diamond | 96,0 % | 93,7 % | – | Naturwissenschaftliche Fragen auf Doktoratsniveau |
Für die Mittelklasse gibt es einen gemeinsamen Index eines unabhängigen Analysehauses, mit den Kosten pro Aufgabe. Er misst allgemeine Intelligenz über viele Tests und zeigt, was Sie pro Aufgabe zahlen:
| Modell | Intelligenz-Index | Kosten pro Aufgabe |
|---|---|---|
| Claude Sonnet 5.5 | 56,0 | 1,08 USD |
| Gemini 4 Argon | 52,6 | 1,99 USD |
| GPT-6.1 Sol | 51,8 | 0,72 USD |
| GPT-6 Astra (zum Vergleich) | – | 3,26 USD |
Für Claude Opus 5.5 hat Anthropic nur relative Vergleiche veröffentlicht: auf einem Coding-Test besser als GPT-6 Astra zu rund einem Fünftel der Kosten pro Aufgabe, auf Terminal-Bench 4.0 gleichauf mit Astra zu rund 40 Prozent der Kosten. Unabhängige Werte stehen noch aus.
Was wir selbst gemessen haben
Für unsere Branchenstudien im Oktober haben wir drei der aktuellen Modelle mit Websuche identische Fragen gestellt: GPT-6.1 Sol in ChatGPT, Claude Sonnet 5.5 und Gemini 3.8 Flash. Je 32 Antworten pro Modell zu Immobilienmaklern, ästhetischer Medizin, Badsanierung und Haustechnik in Zürich. Das ist kein Benchmark, aber es zeigt die Persönlichkeit der Modelle sehr deutlich:
| GPT-6.1 Sol (ChatGPT) | Claude Sonnet 5.5 | Gemini 3.8 Flash | |
|---|---|---|---|
| Firmen pro Antwort | rund 3 | rund 7 bis 9 | rund 6 bis 8 |
| Zitierte Quellen pro Antwort | rund 3 bis 4 | rund 5 bis 6 | rund 7 bis 9 |
| Länge pro Antwort | rund 300 Wörter | rund 350 bis 400 Wörter | rund 370 bis 420 Wörter |
GPT-6.1 Sol wählt aus und begründet knapp. Wer ChatGPT nach einem Anbieter fragt, bekommt eine kurze Liste, oft mit einer klaren persönlichen Empfehlung. Claude Sonnet 5.5 nennt mehr Namen und ist vorsichtiger: Bei der Frage nach einem Sanitär-Notdienst unterschied es von sich aus zwischen Betrieben mit eigenem Sitz in Zürich und reinen Vermittlungs-Hotlines und riet, Preise vorab zu erfragen. Gemini 3.8 Flash liest am meisten Quellen und liefert die längsten Antworten, mit vielen Namen aus Verzeichnissen und Listen.
Für Unternehmen, die in diesen Antworten vorkommen wollen, heisst das: ChatGPT ist der engste Flaschenhals. Wer dort unter den drei Namen stehen will, braucht die überzeugendste Seite zur gestellten Frage. Wie man das misst, steht in KI-Sichtbarkeit messen.
Welches Modell ich für welche Aufgabe nehme
| Aufgabe | Meine Wahl | Warum |
|---|---|---|
| Anspruchsvolles Coding, Architektur | Claude Fable 5.1 | Bleibt für mich das beste Coding-Modell, trotz geteilter Benchmarks |
| Alltägliches Coding, Agenten mit vielen Schritten | Claude Opus 5.5 | Fast Fable-Niveau für weniger als die Hälfte |
| 3D, Blender, Unreal | GPT-6 Astra | Hier ist Astra wirklich, wirklich gut |
| Texte, E-Mails, Konzepte | Claude Sonnet 5.5 oder Opus 5.5 | Natürlicher Ton, gutes Deutsch |
| Recherche mit vielen Quellen | Gemini 4 Argon oder GPT-6.1 Sol | Argon stark bei Erklärungen und Sprachen, Sol günstig und präzise |
| Agentische Aufgaben mit vielen Aufrufen | GPT-6.1 Sol | Tiefste Kosten pro Aufgabe in der Mittelklasse |
| Klassifizieren, Zusammenfassen in Mengen | Claude Haiku 5.5 oder GPT-6 Luna | Kostet fast nichts, reicht für klar definierte Aufgaben |
Mein Setup aus dem Juli, ein starkes Modell als Planer und ein günstigeres als Ausführer, funktioniert mit der neuen Mittelklasse noch besser: Fable 5.1 oder Opus 5.5 plant und prüft, GPT-6.1 Sol oder Sonnet 5.5 setzt die einzelnen Schritte um. Für Agenten im Unternehmen beschreibt KI-Agenten im Unternehmen, wie man so etwas sicher aufbaut.
Was Entwickler nach den ersten Wochen sagen
- Claude Opus 5.5: Gelobt werden der natürlichere Schreibstil und die Effizienz. Kritik gibt es an den wöchentlichen Nutzungslimits in den Abos, die bei Multi-Agenten-Arbeit schnell erreicht sind, und an Ablehnungen bei Sicherheitsthemen. Viele fragen, warum sie nicht gleich Sonnet 5.5 nehmen sollen.
- Claude Sonnet 5.5: Gilt als gute, günstige Wahl für klar abgegrenzte Aufgaben.
- GPT-6.1 Sol: Das Preis-Leistungs-Verhältnis wird fast durchwegs gelobt. Diskutiert wird, dass das Modell laut OpenAIs eigener Sicherheitsdokumentation häufiger als Astra an einer Aufgabe festhält, obwohl es abbrechen sollte.
- Gemini 4 Argon: Gelobt für Texte, Erklärungen, nicht-englische Sprachen und Tempo. Kritisiert werden Denkschleifen, die nicht enden, beim agentischen Coding ein Rückstand auf Claude und der verwirrende, auf teure Abos beschränkte Start.
Datenschutz: was Schweizer KMU prüfen sollten
Die Modellwahl ist auch eine Vertragsfrage. Für Firmendaten gehören drei Dinge geklärt: ein Business- oder API-Vertrag, der das Training auf Ihren Daten ausschliesst, eine Vereinbarung zur Auftragsverarbeitung nach revDSG und, je nach Daten, ein Hosting in der EU oder der Schweiz. Microsoft bietet OpenAI-Modelle über Azure auch in der Region Schweiz Nord an, Claude ist über AWS und Google Cloud in EU-Regionen verfügbar. Neue Modelle kommen dort oft mit Verzögerung an, prüfen Sie deshalb für jedes Modell, ob es in Ihrer Region schon angeboten wird. Mehr dazu in KI und Datenschutz in der Schweiz und in Interne KI-Richtlinie.
Fazit
Die wichtigste Veränderung im Herbst 2026 ist nicht ein neues Spitzenmodell, sondern die neue Mittelklasse. GPT-6.1 Sol, Claude Opus 5.5, Sonnet 5.5 und, vorerst zum Einführungspreis, Gemini 4 Argon machen die teuersten Modelle für die meisten Aufgaben überflüssig. Meine Empfehlung für KMU: Standardmässig ein Mittelklasse-Modell, ein Spitzenmodell nur für die wirklich schweren Aufgaben, ein Billigmodell für die Masse. Und vor jeder grösseren Entscheidung ein Test mit den eigenen Aufgaben. Wie Ihr Team das im Alltag umsetzt, zeigen unsere KI-Workshops für KMU. Den Vergleich vom Juli mit Fable 5, GPT-5.6 Sol und Kimi K3 finden Sie in KI-Modelle im Vergleich 2026.
Über den Autor